Training: Firebird SQL and Pascal Programming for the Next Generation
(German language version here)
November 16-18, 2026, 9.00 am - 5.00 pm in Munich, Germany
Three intensive days of training for the next generation of developers: participants will learn how Pascal projects are structured using Delphi and Lazarus, how Firebird databases work, and how both are professionally integrated in IBExpert.
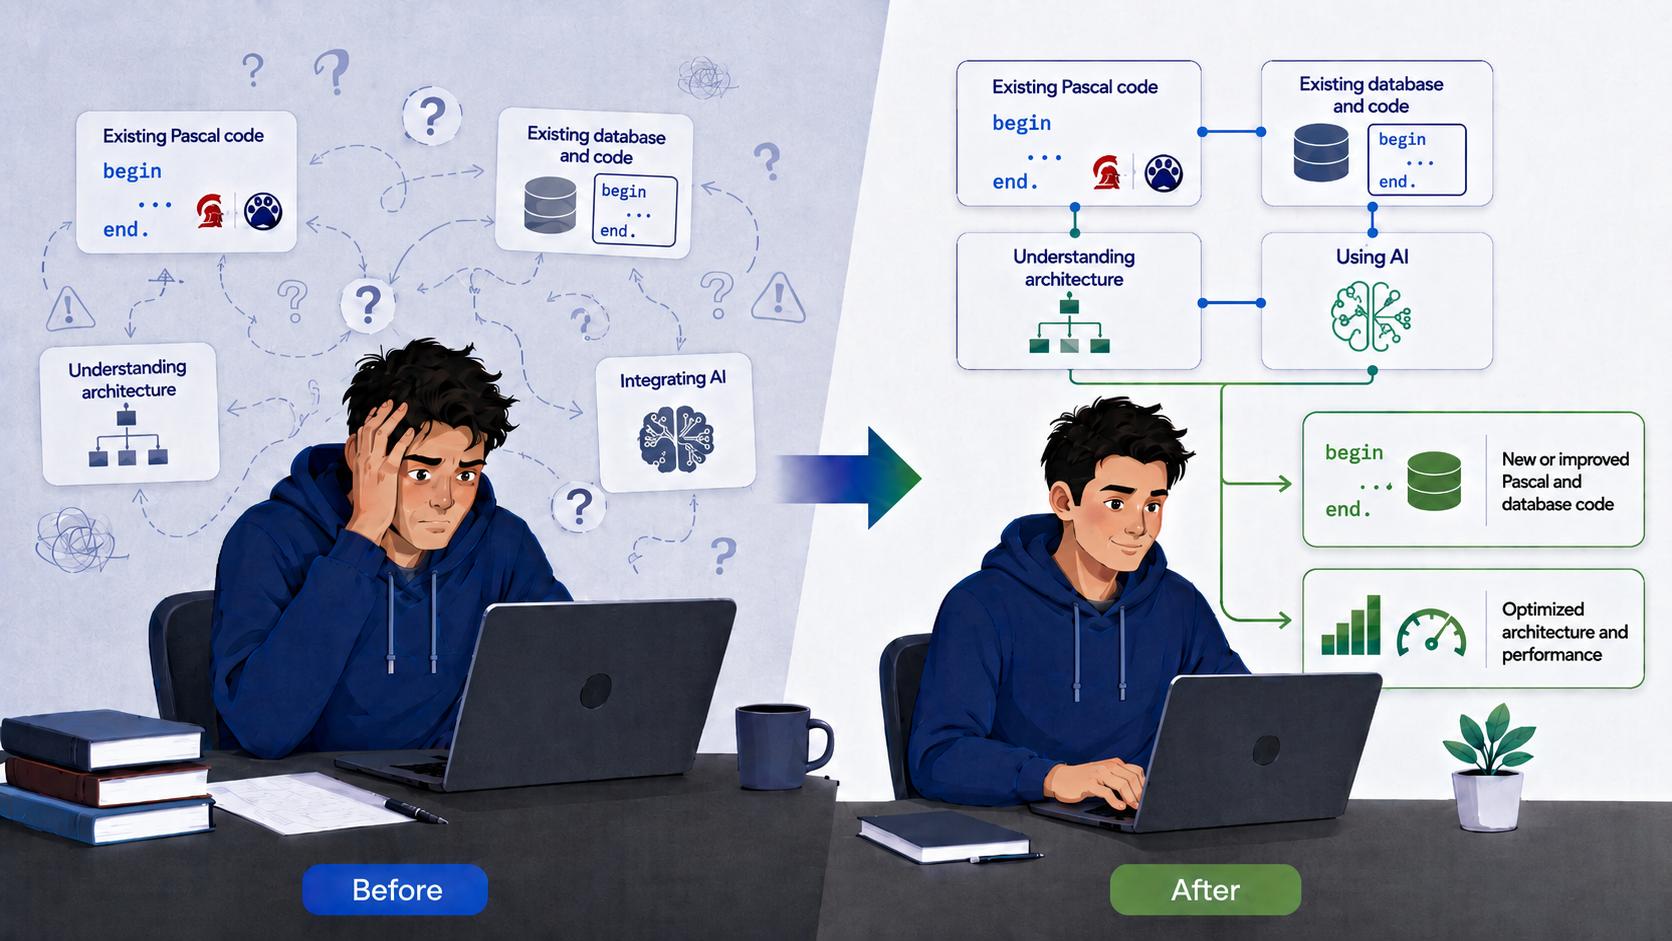
The focus is not on theoretical language details, but on the knowledge young developers require to be able to contribute productively to existing business projects – including the sensible and responsible use of AI tools such as ChatGPT and Codex.
Further information:
https://ibexpert.net/cms/training
Registration: register@ibexpert.net
This three-day practical training course can also be booked as a remote or on-site in-house training course, in which case we can use your existing software and database as a basis.
For the next generation of developers
Not as a retrospective look at old development environments, but as a practical introduction for people who will be working productively on existing systems in the future. No practical experience with Delphi, Lazarus, Firebird or IBExpert is required.
Suitable for
|
Recommended requirements
|
Risks of business software as a cloud solution
Firebird White Paper
Holger Klemt, January 2026
What should you do if your Porsche won't start or your cloud ERP is no longer usable?
Some readers will no doubt have already read the recent articles about dissatisfied Porsche customers in Russia whose vehicles no longer start, because a globally implemented anti-theft device in the vehicle permanently blocks the vehicle as a precautionary measure due to a lack of cloud access and shuts off the fuel supply in such a way that it cannot be circumvented with simple tricks, even though some providers have already offered workarounds. Porsche has sanctioned all support for Russia for good reasons, so no solution should be expected from that side.
What does this story have to do with a cloud ERP solution?
Well, sooner or later, a number of customers will surely notice this as well.
The idea for this White Paper was triggered by the decision of a medium-sized German company that had been using a self-written Delphi/Firebird application at numerous locations and had expanded it over the course of the last 30 years, implementing processes specific to their needs. Not everything was perfect, but in the area of logistics in particular, constantly changing standards were implemented in such a way that they precisely met their requirements.
Firebird-Datenbankreplikation
Zuverlässige Synchronisation nahezu in Echtzeit für unternehmenskritische Systeme
Holger Klemt, August 2026
Moderne Anwendungen stellen zunehmend Anforderungen an Datenbanken, die über mehrere Standorte, Server und Umgebungen hinweg kontinuierlich verfügbar sein müssen. Ob Hochverfügbarkeit, die Migration von einer Desktop-Anwendung zu einer webbasierten Lösung, verteilte Datenbanken oder die kontinuierliche Synchronisierung zwischen verschiedenen Rechenzentren – eine zuverlässige Datenbankreplikation ist dabei ein entscheidender Bestandteil.
Unsere Firebird-Replikationslösung wurde genau für solche Szenarien entwickelt. Sie kombiniert transaktionssichere Replikation, Synchronisierung nahezu in Echtzeit, One-to-Many-Replikation und Unterstützung für große Firebird-Datenbanken – und kann in bestehende Produktionsumgebungen integriert werden, ohne die Datenbank offline nehmen zu müssen.
Entwickelt für Firebird
Das Replikationsframework unterstützt Firebird 2.5 und neuere Versionen, einschließlich Firebird 4, Firebird 5 und aktuellen Firebird 6 Datenbanken.
Ein wesentlicher Vorteil besteht darin, dass die Replikation direkt auf Datenbankebene mithilfe von aktiven Triggern und einem Transaktionsprotokoll umgesetzt wird. Änderungen an der Quelldatenbank werden als Transaktionen erfasst und können anschließend an eine oder mehrere Ziel-Datenbanken übertragen werden.
Diese Architektur stellt sicher, dass Änderungen nicht verloren gehen, wenn beispielsweise eine Netzwerkverbindung oder der Replikationsprozess vorübergehend nicht verfügbar ist.
Replikation ohne Ausfallzeit der Produktionsdatenbank
Eine der wichtigsten Anforderungen bei Migrations- oder Hochverfügbarkeitsprojekten besteht darin, die Replikation aktivieren zu können, ohne den laufenden Betrieb der Anwendung zu unterbrechen.
Unser Replikationsverfahren ist genau auf dieses Szenario ausgelegt.
Sobald die Replikation initialisiert wurde, beginnen die erforderlichen Trigger damit, INSERT-, UPDATE- und DELETE-Operationen in einem dedizierten Transaktionsprotokoll zu erfassen. Die Produktionsdatenbank läuft weiterhin einwandfrei.
Die initiale Synchronisierung erfolgt anschließend durch die Erstellung eines Backups der Master-Datenbank und dessen Wiederherstellung auf dem Zielserver. Auch hierfür muss die Produktionsdatenbank nicht offline genommen werden.
Nachdem die Ziel-Datenbank initialisiert wurde, überträgt der Replikationsprozess alle Transaktionen, die während der Erstellung des Backups entstanden sind, und setzt anschließend die kontinuierliche Synchronisierung mit allen neuen Transaktionen fort.
Transaktionssichere Replikation
Zuverlässigkeit steht im Mittelpunkt der Architektur.
Angenommen, die Master-Datenbank hat 100 Transaktionen gesammelt, die noch repliziert werden müssen. Fällt die Netzwerkverbindung aus, nachdem nur ein Teil der Daten übertragen wurde, gehen die verbleibenden Transaktionen nicht verloren.
Sie bleiben im Transaktionsprotokoll gespeichert und werden beim nächsten Replikationsvorgang erneut berücksichtigt.
Der Replikationsprozess ist daher nicht auf eine dauerhaft verfügbare Netzwerkverbindung angewiesen. Ein Zielserver kann sogar über mehrere Tage oder Wochen nicht verfügbar sein, während die Master-Datenbank weiterhin alle für die spätere Synchronisierung erforderlichen Transaktionen erfasst.
Sobald das Zielsystem wieder erreichbar ist, wird die Replikation an der Stelle fortgesetzt, an der sie unterbrochen wurde.
One-to-Many-Replikation
Die Architektur unterstützt auch die One-to-Many-Replikation.
Eine einzelne Master-Datenbank kann ihre Daten an mehrere Zielserver replizieren. Dabei wird jedes Zielsystem unabhängig verwaltet und überwacht.
Beispielsweise:
Master-Server → Slave 1
Master-Server → Slave 2
Master-Server → Slave 3
Ist beispielsweise Slave 2 vorübergehend nicht verfügbar, kann die Replikation zu Slave 1 und Slave 3 normal weiterlaufen. Die für Slave 2 erforderlichen Transaktionen bleiben auf dem Master verfügbar, bis dieses Zielsystem wieder erreichbar ist.
Dadurch eignet sich die Architektur besonders für verteilte Systeme, bei denen einzelne Standorte über unzuverlässige Netzwerkverbindungen verfügen oder Server zeitweise nicht verfügbar sind.
Multi-Master-Replikation
Abhängig von der Struktur der Datenbank kann die Technologie auch eine Multi-Master-Replikation unterstützen.
In einer solchen Konfiguration können mehrere Server als Master-Datenbanken arbeiten und Änderungen untereinander austauschen.
Multi-Master-Umgebungen erfordern jedoch eine sorgfältige Betrachtung des Datenbankdesigns, insbesondere bei der Generierung von Primärschlüsseln. Automatisch generierte Schlüssel müssen beispielsweise so gestaltet sein, dass unabhängig auf verschiedenen Master-Servern erzeugte Datensätze nicht zu Schlüsselkonflikten führen.
Falls erforderlich, können Datenbank-Metadaten und Anwendungslogik entsprechend angepasst werden, um eine solche Architektur zu unterstützen.
Synchronisierung nahezu in Echtzeit
Der Replikationsprozess ist für einen Betrieb nahezu in Echtzeit ausgelegt.
In einer typischen Umgebung werden Transaktionen kontinuierlich über einen Push/Pull-Prozess übertragen. Die tatsächliche Latenz hängt dabei von der Leistungsfähigkeit der Server, dem Transaktionsvolumen und den Netzwerkbedingungen ab.
In einer großen verteilten Installation waren Änderungen an entfernten Standorten typischerweise innerhalb von weniger als 10 Sekunden verfügbar. Selbst bei hoher Systemlast lag die Verzögerung in der Regel bei etwa einer Minute.
Auch Standorte mit langsameren oder zeitweise unzuverlässigen Internetverbindungen konnten weiterhin lokal arbeiten. Sobald die Verbindung wiederhergestellt war, wurden die aufgelaufenen Transaktionen automatisch synchronisiert.
Bewährt bei großen und verteilten Firebird-Installationen
Die Technologie wurde bereits in anspruchsvollen Produktivumgebungen mit großen Datenbanken und geografisch verteilten Systemen eingesetzt.
Ein besonders umfangreiches Projekt umfasste:
- 9 zentrale Server
- 6 verschiedene Rechenzentren und Städte
- Rund 225 Firebird-Datenbanken an einzelnen Standorten
- Etwa 500 GB für die größte zentrale Datenbank
- Rund 2 Milliarden Datensätze in der größten Datenbank
- Etwa 5–6 Millionen INSERT-, UPDATE- und DELETE-Operationen pro Tag
- Synchronisierung nahezu in Echtzeit zwischen den zentralen Systemen und den einzelnen Standorten
Die einzelnen Datenbanken an den entfernten Standorten enthielten jeweils Teilmengen der zentralen Daten und übertrugen lokale Änderungen zurück an die zentrale Infrastruktur.
Auch bei unzuverlässigen Netzwerkverbindungen an einzelnen Standorten stellte die Replikationsarchitektur sicher, dass Transaktionen solange verfügbar blieben, bis sie erfolgreich übertragen werden konnten.
Umgang mit sehr großen Datenbanken und BLOB-Daten
Große Firebird-Datenbanken können erhebliche Mengen an BLOB-Daten enthalten, insbesondere in Anwendungen aus Bereichen wie Gesundheitswesen, Dokumentenmanagement, Bildverarbeitung oder Archivierung.
In einer anderen Installation erreichte die gesamte Datenbankumgebung einschließlich Transaktions-protokollen und jährlicher BLOB-Datenbanken eine Größe von rund 7 TB.
Bei sehr großen Datenmengen kann es sinnvoll sein, historische Daten in separate Datenbanken auszulagern.
Beispielsweise können jährliche Transaktions- oder BLOB-Datenbanken nach Abschluss eines Geschäftsjahres geschlossen und schreibgeschützt werden. Sie bleiben weiterhin über die Hauptdatenbank zugänglich, vergrößern jedoch nicht mehr die aktive Produktionsdatenbank.
Dieser Ansatz kann zukünftige Backup- und Restore-Vorgänge erheblich vereinfachen und beschleunigen.
Kein Single Point of Failure im Replikationsprozess
Ein vorübergehender Ausfall eines Zielservers oder einer Netzwerkverbindung führt nicht dazu, dass die Master-Datenbank keine Änderungen mehr erfassen kann.
Dies ist insbesondere bei verteilten Installationen von großer Bedeutung.
Ein entfernter Server kann neu gestartet werden, die Netzwerkverbindung verlieren oder über einen längeren Zeitraum nicht verfügbar sein. Sobald er wieder erreichbar ist, kann der Replikationsprozess mit den Transaktionen fortgesetzt werden, die während seiner Abwesenheit im Transaktionsprotokoll gespeichert wurden.
Das Ergebnis ist eine Replikationsarchitektur, die auf zuverlässiger nachträglicher Synchronisierung ohne Datenverlust basiert und nicht voraussetzt, dass alle Server und Netzwerkverbindungen jederzeit verfügbar sind.
Die Datenbank-Metadaten spielen eine entscheidende Rolle
Eine zuverlässige Replikation beginnt mit einem geeigneten Datenbankdesign.
Idealerweise verfügt jede Tabelle, die repliziert werden soll, über einen Primärschlüssel oder zumindest über einen geeigneten eindeutigen Index.
Auch Primärschlüssel sollten möglichst kompakt sein. Extrem komplexe Primärschlüssel, die sich über eine große Anzahl von Spalten erstrecken, können die Replikation und die Entwicklung der Anwendung unnötig komplizieren.
Tabellen ohne Primärschlüssel benötigen gegebenenfalls einen alternativen Mechanismus zur eindeutigen Identifizierung von Datensätzen. Abhängig von der Struktur der Datenbank kann hierfür eine Technologie auf Basis von Firebirds RDB$DB_KEY in Betracht gezogen werden.
Bei komplexen Datenbankumgebungen können die Metadaten bereits vor Beginn der Implementierung analysiert werden, um die geeignete Replikationsstrategie zu bestimmen.
Kontinuierliche Replikation mit geringem Wartungsaufwand
Nach der Implementierung arbeitet das Replikationssystem weitgehend im Hintergrund.
In vielen Installationen ist keine regelmäßige manuelle Wartung erforderlich.
Dennoch kann es vorkommen, dass Datenbankadministratoren umfangreiche Änderungen an den Metadaten oder der Datenbankstruktur durchführen. In solchen Fällen kann es erforderlich sein, die Replikation neu zu initialisieren oder anzupassen.
Für diese Situationen kann technische Unterstützung über ein Prepaid-Support- und Hotline-System bereitgestellt werden. Administratoren können dadurch bei Bedarf Unterstützung anfordern, ohne einen permanenten Wartungsvertrag ausschließlich für gelegentliche Replikationsvorgänge abschließen zu müssen.
Implementierung und Migration
Jedes Replikationsprojekt ist unterschiedlich. Die Größe einer Datenbank allein reicht daher nicht aus, um den tatsächlichen Implementierungsaufwand zu bestimmen.
Vor Beginn eines Projekts empfehlen wir daher eine Analyse der folgenden Punkte:
- Datenbank-Metadaten
- Primärschlüssel und Indizes
- Datenbankstatistiken
- Anzahl und Größe der Datenbanken
- Transaktionsvolumen
- Verwendung von BLOB-Daten
- Netzwerkarchitektur
- Anzahl der Replikationsziele
- Gewünschte Replikationsrichtung
- Anforderungen an Verfügbarkeit und Wiederherstellung
Für eine erste technische Bewertung genügt häufig bereits ein Metadata-Only-Backup. Dadurch kann die Struktur der Datenbank analysiert werden, ohne dass sensible Kundendaten bereitgestellt werden müssen.
Die Implementierung und Schulung können vollständig remote durchgeführt werden – auch bei Kunden in weit entfernten Zeitzonen.
Quellcode und Anpassungsmöglichkeiten
Das Replikationsframework kann zusammen mit seinem Quellcode bereitgestellt werden. Dadurch haben Kunden die Möglichkeit, die Funktionsweise nachzuvollziehen, Anpassungen vorzunehmen und die Lösung in ihre bestehende Systemumgebung zu integrieren.
Dies ist insbesondere dann von Vorteil, wenn die Replikation Teil eines größeren Migrationsprojekts ist, beispielsweise bei der Umstellung einer bestehenden Desktop-Anwendung auf eine webbasierte Architektur, während das bestehende Produktivsystem weiterhin verfügbar bleiben soll.
Eine praktische Grundlage für die Systemmigration
Datenbankreplikation ist besonders wertvoll, wenn ein Unternehmen eine bestehende Anwendung modernisieren möchte, ohne längere Ausfallzeiten in Kauf nehmen zu müssen.
Beispielsweise kann ein Krankenhausinformationssystem (KIS) zusammen mit einer zugehörigen Bilddatenbank kontinuierlich verfügbar bleiben müssen, während die bestehende Desktop-Anwendung schrittweise auf eine moderne Webanwendung migriert wird.
Eine transaktionsbasierte Replikationsschicht kann dabei als Brücke zwischen der bestehenden und der neuen Systemumgebung dienen. Beide Systeme können parallel betrieben werden, während die Daten kontinuierlich synchronisiert werden.
Dadurch lassen sich Migrationsrisiken erheblich verringern und ein kontrollierter Übergang anstelle einer disruptiven „Big-Bang“-Migration ermöglichen.
Eine Lösung, die auf langjähriger Praxiserfahrung basiert
Die hier beschriebene Architektur wurde nicht nur für theoretische Szenarien entwickelt. Sie wird seit mehr als einem Jahrzehnt in anspruchsvollen Produktivumgebungen mit geografisch verteilten Firebird-Datenbanken, großen Transaktionsvolumina, unzuverlässigen Netzwerkverbindungen und erheblichen Datenmengen eingesetzt.
Die Kombination aus Transaktionsprotokollierung, triggerbasierter Erfassung von Änderungen, Push/Pull-Replikation und unabhängiger Verwaltung der einzelnen Replikationsziele bietet eine robuste Grundlage für hochverfügbare und verteilte Firebird-Systeme.
Für Unternehmen, die eine Firebird-Migration, ein Hochverfügbarkeitsprojekt, eine verteilte Datenbankarchitektur oder eine Synchronisierung nahezu in Echtzeit planen, ist eine technische Analyse der bestehenden Datenbankumgebung der erste Schritt.
Auf Grundlage der Datenbank-Metadaten und aktueller Datenbankstatistiken können anschließend eine realistische Implementierungsplanung, eine geeignete Replikationsarchitektur und ein projektspezifisches Angebot erstellt werden.
Firebird Database Replication
Reliable, Near-Real-Time Synchronization for Mission-Critical Systems
Holger Klemt, August 2026
Modern applications increasingly require databases to remain available across multiple locations, servers, and environments. Whether the goal is high availability, migration from a desktop application to a web-based system, distributed databases, or continuous synchronization between data centers, reliable database replication is a critical component.
Our Firebird replication solution has been developed for precisely these scenarios. It combines transaction-safe replication, near-real-time synchronization, one-to-many replication, and support for large Firebird databases — while allowing replication to be introduced into an existing production environment without taking the database offline.
Designed for Firebird
The replication framework supports Firebird 2.5 and newer versions, including Firebird 4, Firebird 5 and current Firebird 6 databases.
A key advantage is that replication is implemented directly at the database level using active triggers and a transaction log. Changes made to the source database are recorded as transactions and can subsequently be transferred to one or more target databases.
This architecture ensures that changes are not lost simply because the network connection or replication process is temporarily unavailable.
Replication without production downtime
One of the most important requirements in a migration or high-availability project is the ability to activate replication without interrupting the running application.
Our replication process is designed for exactly this purpose.
Once replication is initialized, the required triggers begin recording INSERT, UPDATE and DELETE operations in a dedicated transaction log. The production database continues to operate normally.
The initial synchronization can then be performed by creating a backup of the master database and restoring it on the target server. This process can also be performed without taking the production database offline.
After the target database has been initialized, the replication process transfers all transactions that occurred while the backup was being created and subsequently continues with new transactions.
Transaction-safe replication
Reliability is at the heart of the architecture.
Imagine that the master database has accumulated 100 transactions waiting to be replicated. If the network connection fails after only part of the data has been transferred, the remaining transactions are not lost.
They remain in the transaction log and are transferred during the next replication operation.
The replication process therefore does not depend on a permanently available network connection. A target server can even be unavailable for days or weeks while the master database continues to collect the transactions required for synchronization.
When the target becomes available again, replication can continue from where it stopped.
One-to-many replication
The architecture also supports one-to-many replication.
A single master database can replicate its data to multiple target servers. Each target is tracked independently.
For example:
Master Server → Slave 1
Master Server → Slave 2
Master Server → Slave 3
If Slave 2 is temporarily offline, replication to Slave 1 and Slave 3 can continue normally. The transactions required for Slave 2 remain available on the master until that target reconnects.
This makes the architecture suitable for distributed systems where individual locations may have unreliable network connections or temporarily unavailable servers.
Multi-master replication
Depending on the database structure, the technology can also support multi-master replication.
In this configuration, several servers can act as master databases and exchange changes between one another.
However, multi-master environments require careful consideration of the database design, particularly primary-key generation. For example, automatically generated keys must be designed so that records created independently on different master servers cannot produce conflicts.
Where necessary, database metadata and application logic can be adapted to support this architecture.
Near-real-time synchronization
The replication process is designed for near-real-time operation.
In a typical environment, transactions are transferred continuously through a push/pull process. The actual latency depends on server performance, transaction volume and network conditions.
In one large distributed deployment, changes were typically visible at remote locations in less than 10 seconds. Even under periods of very high system load, latency generally remained within approximately one minute.
Locations with slower or unreliable Internet connections could continue operating locally. Once connectivity was restored, accumulated transactions were synchronized automatically.
Proven with large and distributed Firebird installations
The technology has been used in demanding real-world environments involving large databases and geographically distributed systems.
One particularly extensive project involved:
- 9 central servers
- 6 different data centers and cities
- Approximately 225 Firebird databases at individual locations
- Approximately 500 GB in the largest central database
- Around 2 billion records in the largest database
- Approximately 5–6 million INSERT, UPDATE and DELETE operations per day
- Near-real-time synchronization between the central systems and remote locations
The individual remote databases contained subsets of the central data and synchronized local changes back to the central infrastructure.
Despite unreliable network connections at some locations, the replication architecture ensured that transactions remained available until they could be transferred successfully.
Handling very large databases and BLOB data
Large Firebird databases can contain substantial amounts of BLOB data, particularly in applications such as healthcare, document management, imaging and archive systems.
In one implementation, the overall database environment reached approximately 7 TB, including transaction logs and annual BLOB databases.
For very large datasets, separating historical data into dedicated databases can provide significant advantages.
For example, annual transaction or BLOB databases can be closed and made read-only at the end of a financial year. They remain accessible via the main database, but no longer increase the size of the active production database.
This approach can significantly simplify and accelerate future backup and restore operations.
No single point of failure in the replication process
A temporary failure of a target server or network connection does not stop the master database from recording changes.
This is particularly important for distributed installations.
A remote server may be restarted, disconnected, or unavailable for an extended period. Once it becomes available again, the replication process can continue using the transactions that accumulated while it was offline.
The result is a replication architecture designed around reliable, post-event synchronization without data loss, which does not require all servers and network connections to be permanently available.
Database metadata plays a crucial role
Reliable replication starts with a suitable database design.
Ideally, every table that needs to be replicated should have a primary key or at least a suitable unique index.
Primary keys should also be reasonably compact. Extremely complex primary keys spanning a large number of columns can make replication and application development unnecessarily complicated.
Tables without primary keys may require an alternative identification mechanism. Depending on the database structure, a different technology based on Firebird's RDB$DB_KEY can be considered.
For complex environments, the database metadata can be analyzed before implementation to determine the most appropriate replication strategy.
Continuous replication with minimal maintenance
Once implemented, the replication system is designed to operate largely in the background.
In many installations, no regular manual maintenance is required.
Nevertheless, database administrators may occasionally perform extensive metadata changes or structural modifications that require replication to be reinitialized or adjusted.
For such situations, remote technical assistance can be provided through a prepaid support and hotline system. This allows administrators to request assistance when required rather than maintaining a permanent support contract solely for occasional replication operations.
Implementation and migration
Every replication project is different. Database size alone is not sufficient to determine the implementation effort.
Before a project begins, we therefore recommend analyzing:
- The database metadata
- Primary keys and indexes
- Database statistics
- Number and size of databases
- Transaction volume
- BLOB usage
- Network topology
- Number of replication targets
- Required replication direction
- Expected availability and recovery requirements
A metadata-only backup is often sufficient for the initial technical assessment. This allows the database structure to be reviewed without providing access to sensitive customer data.
Implementation and training can be carried out entirely remotely – even for customers in distant time zones.
Source code and customization
The replication framework can be delivered together with its source code, allowing customers to understand, adapt and integrate the solution into their own environment.
This is particularly valuable when replication forms part of a larger migration project, such as moving an existing desktop application to a web-based architecture while keeping the existing production system operational during the transition.
A practical foundation for system migration
Database replication is especially valuable when an organization needs to modernize an existing application without accepting prolonged downtime.
For example, a healthcare information system (HIS) and its associated image database may need to remain continuously available while the underlying application is migrated from a desktop architecture to a modern web application.
A transaction-based replication layer can provide a bridge between the existing and new environments, allowing both systems to operate while data is continuously synchronized.
This can substantially reduce migration risks and enable a controlled transition rather than a disruptive "big bang" migration.
A solution built on real-world experience
The architecture described here is not limited to laboratory scenarios. It has been used for more than a decade in demanding production environments with geographically distributed Firebird databases, large transaction volumes, unreliable network connections and substantial amounts of data.
The combination of transaction logging, trigger-based change tracking, push/pull replication and independent target tracking provides a robust foundation for high-availability and distributed Firebird environments.
For organizations planning a Firebird migration, high-availability project, distributed database architecture or near-real-time synchronization solution, the first step is a technical review of the existing database environment.
With the database metadata and current database statistics available, a realistic implementation plan, replication architecture and project-specific quotation can be prepared.